-
为什么三种正态性检验,得出的结果可能不一样?看懂P值,不要再误判数据是否正态!
在使用SPC系统进行数据分析时,很多质量工程师都会遇到一个问题:
同样一批生产数据,为什么使用不同的正态性检验方法,得到的P值却不一样?
有时候三种方法都认为数据符合正态分布,有时候却可能出现一种方法认为符合,另一种方法认为不符合。
究竟哪个结果才是正确的?
是不是软件计算错了?
其实,这并不是软件出错,而是因为不同的正态性检验方法,判断数据分布的角度并不完全相同。
今天,我们就用质量工程师能够看懂的方式,把这个问题讲清楚。
一、先理解:什么是正态性检验?
在介绍三种方法之前,我们先弄明白一个基础问题。
假设一家工厂正在生产某个精密零件,需要检测产品的尺寸。
连续收集了100个产品的测量数据,然后绘制成直方图。
如果数据大致呈现下面这种形状:
- 中间的数据比较多。
- 越靠近两边,数据越少。
- 左右两侧大致对称。
- 整体呈现类似钟形的曲线。
那么,这组数据就可能接近正态分布。
正态性检验,就是通过统计方法判断:当前这批数据与理论上的正态分布是否存在明显差异。
这里要注意,正态性检验并不是直接判断产品合不合格,也不是判断生产过程是否稳定。
它主要回答的是一个问题:
这批数据是否有足够的统计证据表明,它偏离了正态分布?
二、三种正态性检验,就像三个不同角度的检查员
斌果SPC的正态性检验功能,提供了三种常见的统计检验方法:
- Anderson-Darling Test(安德森-达林检验)
- D'Agostino and Pearson Omnibus Normality Test(达戈斯蒂诺-皮尔逊综合正态性检验)
- Shapiro-Wilk Test(夏皮罗-威尔克检验)
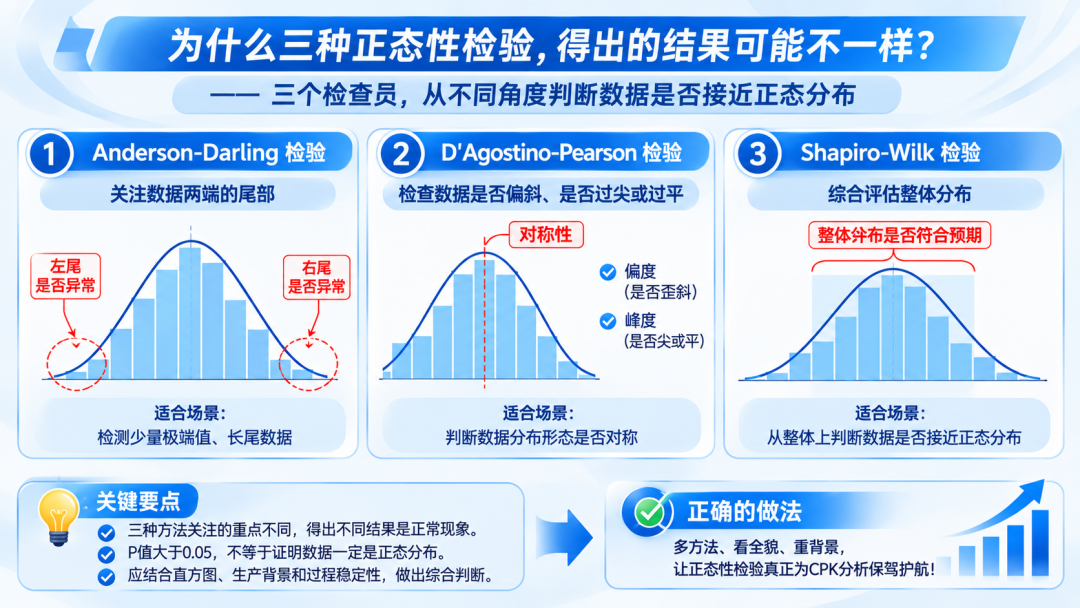
它们的目标都是检查数据是否符合正态分布,但检查的侧重点不同。
我们可以把它们理解为三个不同的质量检查员。
1)Anderson-Darling:特别关注数据两端的尾部
想象一下,一批产品尺寸数据,大部分都集中在50附近。
但有少量产品的尺寸特别大,或者特别小。
这时候,虽然整体直方图看起来比较像钟形,但两端可能存在一些不寻常的数据。
Anderson-Darling检验,就比较关注样本分布与理论分布之间的差异,尤其对分布尾部的差异比较敏感。
通俗地说:
它不只是看中间的数据像不像正态分布,也会特别留意两头的数据有没有异常偏离。
为什么这对制造业很重要?
因为在质量管理中,两端的数据往往与规格超出风险有关。
例如:
- 产品尺寸接近上规格限或下规格限。
- 少量产品出现特别大的测量值。
- 某些数据形成较长的尾巴。
这些情况都值得质量工程师进一步关注。
2)D'Agostino-Pearson:重点检查数据是否偏斜、是否过于尖或平
我们先理解两个词:
偏度(Skewness): 主要描述数据分布是否左右对称。
例如,数据大部分集中在左边,右边拖着一条长尾,这就是一种右偏分布。
峰度(Kurtosis): 主要描述数据分布的尖峭程度,以及尾部相对于正态分布的特征。
例如:
- 数据过于集中,中间显得特别尖。
- 数据分布比较平坦。
- 数据尾部特征与正态分布存在明显差异。
D'Agostino-Pearson检验,就是综合利用偏度和峰度的信息,判断数据是否与正态分布存在明显差异。
通俗地说:
它主要检查这批数据是不是歪了,或者是不是太尖、太平了。
举个生产现场的例子:
某项化学浓度指标,大部分数据集中在较低区域,少量数据向高值方向延伸。
这时,数据可能出现明显的右偏。
D'Agostino-Pearson检验就可以从偏度和峰度的角度,帮助工程师判断这种分布特征是否明显偏离正态分布。
3)Shapiro-Wilk:综合观察整组数据是否符合正态分布的预期
Shapiro-Wilk是非常常见的一种正态性检验方法。
它的计算原理相对复杂,我们不需要记住公式。
可以简单理解为:
它会根据正态分布的理论特征,检查当前样本数据整体排列和分布情况是否吻合。
通俗地说:
它像是在检查整支队伍的排列是否符合正态分布应有的规律,而不是只盯着某一个位置。
它会综合考虑样本数据的分布特征,因此能够帮助工程师判断整组数据与正态分布之间是否存在明显差异。
三、为什么同一批数据,三种方法会得出不同结果?
现在我们回到最开始的问题。
假设某工厂收集了一批产品尺寸数据。
这批数据有以下特点:
- 大部分数据集中在中间区域。
- 整体看起来比较接近钟形。
- 但是右侧有少量较大的数据。
- 两端的数据与理想正态分布存在一些差异。
这时候,三种检验方法可能出现不同的判断。
原因在于:
检验方法 更关注什么 可能出现的情况 Anderson-Darling 整体分布差异,尤其关注尾部 对尾部偏离比较敏感 D'Agostino-Pearson 偏度与峰度 如果整体偏度、峰度不明显,可能仍未发现显著差异 Shapiro-Wilk 样本整体与正态分布的吻合程度 根据整体样本特征得出检验结果 注意:这只是帮助理解的示例,并不是说只要出现右侧长尾,三种检验就一定会得出上述结果。实际结果还取决于样本量、数据形态和偏离程度。
所以,同一批数据得到不同P值,是完全可能发生的。
三种方法不是在争论谁对谁错,而是从不同统计角度检查同一批数据。
四、P值到底怎么看?0.05又是什么意思?
这是实际使用中最重要的部分。
很多工程师看到正态性检验结果,最先关注的就是P值。
那么,P值是什么?
我们可以先不考虑复杂的统计公式。
在正态性检验中,通常设定:
- 原假设H0:数据来自正态分布。
- 备择假设H1:数据不来自正态分布。
假设我们采用0.05作为显著性水平。
那么判断方式是:
P值 统计判断 通俗理解 P≤0.05 拒绝原假设H0 有足够统计证据表明数据偏离正态分布 P>0.05 不拒绝原假设H0 暂时没有足够证据认定数据偏离正态分布 这里特别提醒:
P值大于0.05,并不等于证明数据一定符合正态分布。
它只表示:根据当前样本和检验方法,没有足够证据拒绝正态分布的假设。
这两句话看起来很接近,但统计意义完全不同。
五、结合斌果SPC的真实界面,看一个实际案例
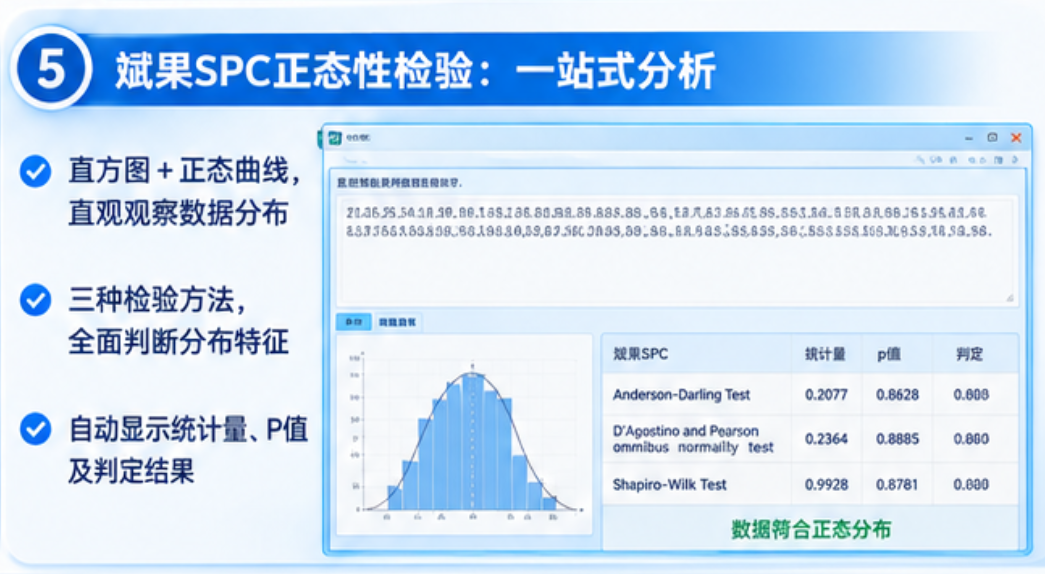
下面是斌果SPC正态性检验功能的实际界面。
系统支持直接输入数据,也可以将Excel中的数据列复制粘贴到数据输入区域。
完成数据输入后,点击分析,系统会自动生成直方图、正态分布曲线,并展示三种正态性检验结果。
以截图中的这组实际数据为例:
检验方法 统计量 P值 系统判定 Anderson-Darling Test 0.2077 0.8628 符合正态分布 D'Agostino-Pearson Test 0.2364 0.8885 符合正态分布 Shapiro-Wilk Test 0.9928 0.8781 符合正态分布 这组数据的三个P值都明显大于0.05。
因此,在0.05的显著性水平下,三种检验方法都没有足够证据拒绝数据符合正态分布的原假设。
从直方图上也可以看到,数据整体呈现比较接近钟形的分布。
这就是三种检验方法得出相近结论的情况。
但如果将来遇到三种方法结果不一致的情况,也不需要慌张。
我们应该进一步检查:
- 直方图是否存在明显偏态或长尾?
- 数据两端是否存在少量极端值?
- 样本量是否足够?
- 是否存在不同设备、批次或工序的数据混合?
- 数据是否存在时间趋势或相关性?
通过这些信息,才能更准确地理解检验结果。
六、三种检验结果不一致,到底应该相信哪一个?
这是很多质量工程师最关心的问题。
我的建议是:
不要简单地选择P值最大的那个方法,也不要只因为某一种方法不通过,就直接判定整批数据不能使用。
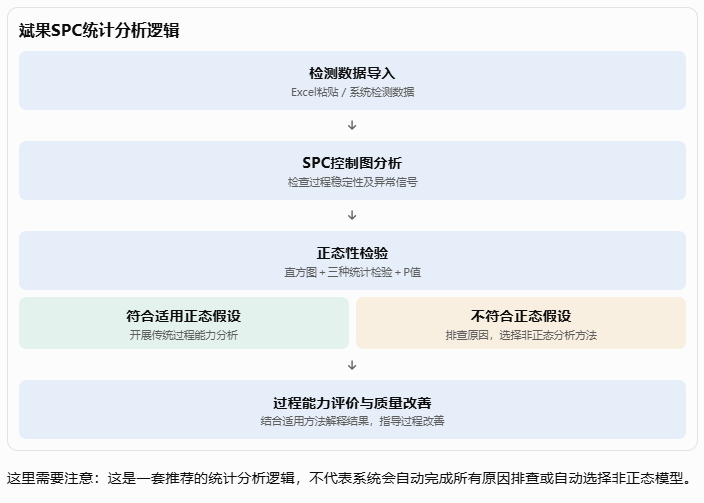
更合理的分析顺序是:
第一步:先观察直方图。
看看数据是否明显偏态、双峰、长尾,或者存在异常聚集。
第二步:查看三种检验结果。
了解不同方法是否得出了相同结论。
第三步:结合生产过程背景。
检查数据是否来自同一设备、同一工艺条件、同一产品型号,以及同一相对稳定的生产阶段。
第四步:结合控制图判断过程稳定性。
如果过程存在明显趋势或特殊原因,就不能只依赖正态性检验结果评价数据。
第五步:根据实际情况选择后续分析方法。
如果数据确实不符合正态分布,应进一步调查原因,必要时采用适合非正态数据的过程能力分析方法。
记住:
正态性检验不是为了得到一个好看的P值,而是为了帮助我们选择正确的统计分析方法。
七、为什么斌果SPC同时提供三种正态性检验?
对于质量工程师来说,正态性检验不是一个只需要计算一次的功能。
不同检测项目、不同生产批次、不同设备的数据,都可能呈现不同的分布特征。
如果只依赖一种检验方法,可能无法从不同统计角度充分了解数据。
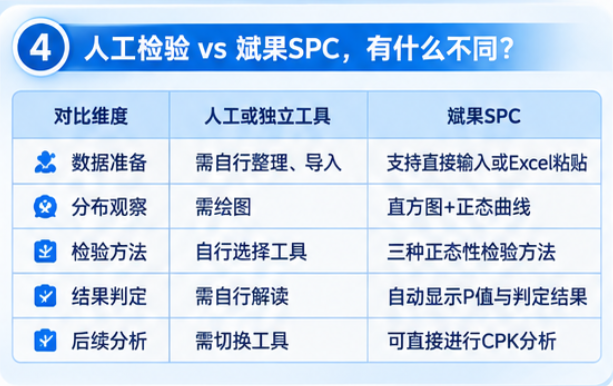
斌果SPC将三种常见正态性检验方法整合在同一个分析界面中:
- 直接输入数据,或从Excel复制粘贴。
- 自动生成数据直方图及正态分布曲线。
- 同时执行三种正态性检验。
- 展示每种方法的统计量与P值。
- 自动显示对应的检验判定结果。
工程师无需在不同工具之间反复切换,就可以在同一界面中观察数据分布并比较不同检验结果。
结合系统中的控制图分析及非正态导入数据CPK分析工具,还可以进一步开展过程稳定性和过程能力评价。
结语:不要只看P值,更要看懂数据
正态性检验看起来只是一个简单的统计分析工具,但真正使用起来,需要理解它背后的统计逻辑。
Anderson-Darling、D'Agostino-Pearson和Shapiro-Wilk,虽然都是正态性检验方法,但它们的统计原理和关注重点并不相同。
因此,同一批数据得到不同的P值,并不奇怪。
对于质量工程师而言,真正重要的不是让三种检验都得到一个漂亮的结果,而是通过统计检验、分布图形和生产现场信息,正确理解数据的分布特征。
先看分布,再看检验;先理解数据,再评价过程能力。
斌果SPC,让统计分析更直观,让质量判断更有依据。
本页面文章与公众号同步。
微信扫码关注
