-
Cpk算出来1.35,就能说过程能力达到1.33吗?
Cpk算出来1.35,就能证明过程能力达到1.33吗?
假设客户要求Cpk≥1.33。
我们收集了最近25个批次的检测数据,计算出来的Cpk是1.35。
1.35大于1.33,看起来没什么问题,过程能力达标了。
但这里有个问题:我们算出来的Cpk=1.35,真的能够代表过程的实际能力吗?
未必。
因为我们计算Cpk时使用的均值和标准差,都是根据有限的检测数据估计出来的。既然是估计,就不可避免地存在抽样误差。
这也是近期一项关于小样本过程能力批准的研究所讨论的问题:当Cpk刚好超过要求时,我们究竟有多大把握认为过程能力真的达标了?
一、Cpk=1.35,其实只是一个估计值
大家都很熟悉Cpk的计算公式:
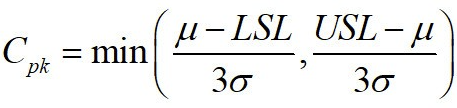
其中,μ是总体均值,σ是总体标准差。
但实际生产中,我们并不知道总体真实的均值和标准差,只能根据收集到的检测数据进行估计。
比如我们用25个数据计算Cpk,得到1.35。
如果换另外25个数据重新计算,结果还会是1.35吗?
通常不会。
可能是1.28,也可能是1.42,甚至更高或者更低。
即使生产过程一直保持稳定,没有发生任何实际变化,不同样本计算出来的Cpk也可能不一样。
原因很简单:每次抽取的数据不同,计算出来的均值和标准差自然也会有差异。
这就是抽样误差。
而且,样本量越少,抽样误差通常越明显。
所以,我们看到的Cpk=1.35,并不意味着真实过程能力就恰好等于1.35。
二、同样是Cpk=1.35,25个数据和1000个数据有多大区别?
我们可以用SPC软件中常见的滚动计算来理解。
假设一个生产过程一直保持稳定,每个批次采集一个检测数据。我们始终使用最近25个数据计算Cpk。
例如:
T时刻,使用T−24~T的25个数据。
到了T+1时刻,使用T−23~T+1的25个数据。
再到T+2时刻,使用T−22~T+2的25个数据。
每增加一个新数据,就去掉最早的一个数据,重新计算一次Cpk。
这样持续下去,我们会得到一条不断变化的Cpk曲线。
有时候是1.35,有时候是1.29,有时候又变成1.41。
这很正常。即使过程没有发生变化,Cpk也不可能每次都完全相同。
不过要注意,相邻两个滚动窗口有24个数据是重复的,所以这些Cpk结果并不是相互独立的。
如果我们想研究Cpk估计值本身的抽样波动,就需要引入一个统计概念:标准误(Standard Error,SE)。
标准误是什么意思?
我们平时说的标准差,通常是描述检测数据本身的离散程度。
而这里的标准误,是描述Cpk这个估计值的波动程度。
可以这样理解:
假设过程真实状态始终不变,我们一次又一次地从这个过程中抽取25个数据,每次都计算一个Cpk。
那么,这些Cpk会有多大的波动?
标准误就是用来衡量这种波动的。
如果重复抽样1000次,就会得到1000个Cpk值。
这1000个Cpk值的标准差,就可以用来估计Cpk的标准误。
标准误越大,说明Cpk估计值越不稳定;标准误越小,说明估计值通常越精确。
如果我们不再使用25个数据,而是每次使用100个,甚至1000个数据计算Cpk,结果又会怎样?
在过程稳定、数据满足相应统计假设的情况下,样本量越大,Cpk估计值的标准误通常就越小。
这里有个区别需要说清楚:
样本量增加,并不会让过程真实的Cpk变大,它只是让我们对真实Cpk的估计更加精确。
三、25个数据与1000个数据,差别到底有多大?
我们来看一组计算结果。
假设不同样本量计算出来的Cpk都是1.35。
在数据独立、服从正态分布,且采用普通样本标准差估计等条件下,可以近似计算出:
样本量 Cpk估计值 近似标准误 近似95%单侧置信下限 25 1.35 0.202 1.02 50 1.35 0.143 1.11 100 1.35 0.101 1.18 200 1.35 0.071 1.23 1000 1.35 0.032 1.30 说明:这是一组特定统计假设下的近似计算示例。不同的标准差估计方法、抽样设计和数据分布,结果可能不同。
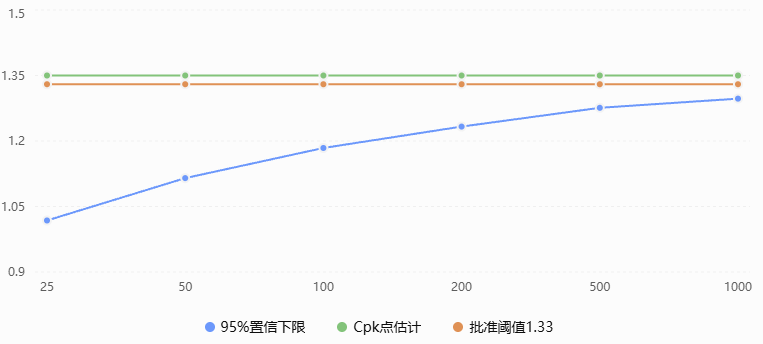
先看第三列,标准误。
25个数据计算出来的Cpk=1.35,标准误约为0.202。
如果增加到1000个数据,虽然Cpk同样是1.35,但标准误只有0.032。
这说明,后者的估计精度明显更高。
不过,真正值得注意的是最后一列:95%单侧置信下限。
什么叫95%单侧置信下限?
简单来说,我们不仅想知道Cpk估计值是多少,还希望根据样本数据,给真实Cpk建立一个有统计保证的下限。
这里的95%,指的是采用这种方法反复抽样时,所构建的下限有大约95%的机会不高于真实Cpk。
例如,25个数据计算得到Cpk=1.35,但对应的近似95%单侧置信下限只有1.02。
这并不是说真实Cpk就是1.02。
而是说,考虑到小样本的抽样不确定性,我们目前还无法以这种置信标准确认真实Cpk至少达到1.33。
再看看1000个数据。
Cpk仍然是1.35,95%单侧置信下限提高到了1.30。
估计已经精确了很多,但1.30还是小于1.33。
也就是说,即使收集了1000个数据,如果Cpk只有1.35,按照这种95%单侧置信下限的批准规则,仍然不能认定已经满足批准条件。
原因并不复杂。
1.35距离1.33只有0.02,实在太接近了。哪怕估计误差已经很小,也可能影响最终判断。
当然,这不代表过程一定不合格。
只是我们还没有足够的统计证据,以这种置信标准证明它已经达到要求。
四、那究竟应该怎样判断Cpk是否达到1.33?
传统的判断方式很直接。
客户要求Cpk≥1.33,我们算出来1.35,于是认为满足要求。
这种做法比较方便,也是很多企业目前采用的方式。
但它没有直接考虑Cpk估计值的抽样不确定性。
2026年发表的一项研究《Risk-calibrated process capability approval with finite samples》,讨论了如何在有限样本条件下,将抽样误差和错误批准的风险纳入过程能力判断。
其中一个容易理解的思路是:
不只是要求Cpk估计值达到1.33,还要求考虑统计不确定性后,仍然能够达到1.33。
例如,我们可以采用95%单侧置信下限作为批准依据。
计算方法是:
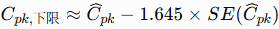

为什么是1.645?
它是正态近似下95%单侧置信水平对应的统计系数。这里不展开推导。
拿前面的25个数据举例:

结果只有1.02,没有达到1.33。
如果采用这套规则,就不能批准。
这里一定要说明:这是一种考虑统计风险的批准方法,并不意味着所有客户、所有行业都必须采用95%单侧置信下限作为强制要求。
如果客户明确规定按Cpk点估计进行判断,仍然需要遵循客户约定的验收规则。
我们讨论的是另一个问题:除了满足数值要求之外,是否有足够的统计证据支持这个判断?
五、为什么要考虑错误批准和错误拒绝?
如果只比较Cpk是否达到1.33,其实存在两种可能的判断错误。
一种是错误批准。
过程真实的Cpk没有达到1.33,但因为这次抽取的样本比较“幸运”,计算出来的Cpk超过了1.33。
企业据此批准生产,后续可能出现较高的不良率,甚至造成客户投诉和批量质量问题。
另一种是错误拒绝。
过程真实的Cpk已经满足要求,但由于抽样波动,计算出来的Cpk偏低,或者没有通过更严格的统计批准条件。
企业因此要求继续收集数据、改善过程,甚至推迟生产。
这同样会造成损失。
但两种错误的代价,往往不一样。
比如汽车安全零部件、医疗器械或者半导体关键工序,错误批准的代价可能非常高。
相比之下,多收集一些数据、延长验证时间,虽然会增加成本,但可能更容易接受。
所以,究竟采用多严格的批准条件,不能只看一个统计公式,还要结合产品风险、客户要求和错误决策可能造成的损失。
这也是这项研究值得关注的地方。
需要指出的是,Cpk置信区间并不是什么全新的统计方法,早在几十年前就已经有相关研究。
这篇研究更有价值的地方,是把有限样本下的估计不确定性,与实际的批准风险联系起来。
六、实际使用时,还有两个问题不能忽略
首先,25个数据到底够不够?
这个问题不能一概而论。
如果只是初步了解过程能力,25个数据当然可以提供一些信息。
但如果希望以较高的置信水平证明真实Cpk超过1.33,尤其计算结果只有1.35时,25个数据通常很难提供充分证据。
还有,25个单值数据,与25组、每组5个数据,也不是同一回事。
不同的抽样方式、标准差估计方法,会影响Cpk估计的精度,不能直接套用同一套标准误计算公式。
其次,过程本身是否稳定?
前面所有关于标准误和置信下限的讨论,都有相应的统计假设。
如果生产过程的均值不断漂移,或者波动程度随着时间变化,那么问题就不只是样本量大小了。
比如我们用最近1000个数据计算Cpk,但这1000个数据跨越了多次设备调整、刀具更换、原材料批次变化。
此时,简单地把它们当作同一个稳定过程的数据,计算一个Cpk及其置信下限,未必具有我们希望的统计意义。
所以,样本量并不是越大就一定越好。
数据是否来自同一个具有代表性的过程,往往比单纯增加数据量更加重要。
七、最后说几句
平时我们评价过程能力,经常会把Cpk当成一个确定的数字。
Cpk=1.20,认为过程能力不足。
Cpk=1.35,认为过程能力满足要求。
Cpk=1.67,认为过程能力很好。
这样的判断简单、直观,也方便交流。
但从统计学角度来看,事情没有这么简单。
因为Cpk不是直接测量出来的,而是根据有限样本估计出来的。
同样是Cpk=1.35,使用25个数据和1000个数据计算,估计精度可能相差很大。
而且,即使计算出来的Cpk已经超过1.33,也不代表我们一定有足够的统计证据,证明真实过程能力已经达到1.33。
因此,评价过程能力时,我们不妨多问两个问题:
这个Cpk是根据多少数据计算出来的?
我们对这个估计结果,究竟有多大把握?
Cpk超过1.33,和有充分证据证明真实Cpk超过1.33,其实是两回事。
这也是为什么过程能力分析不能只盯着最后那个数字。
参考文献
Jiang, F., & Yang, L. (2026). Risk-calibrated process capability approval with finite samples. The International Journal of Advanced Manufacturing Technology.
DOI:https://doi.org/10.1007/s00170-026-18284-2
--end--
玩转SPC系列文章:
本页面文章与公众号同步。
微信扫码关注